Schéma logique du fonctionnement de l'ordinateur
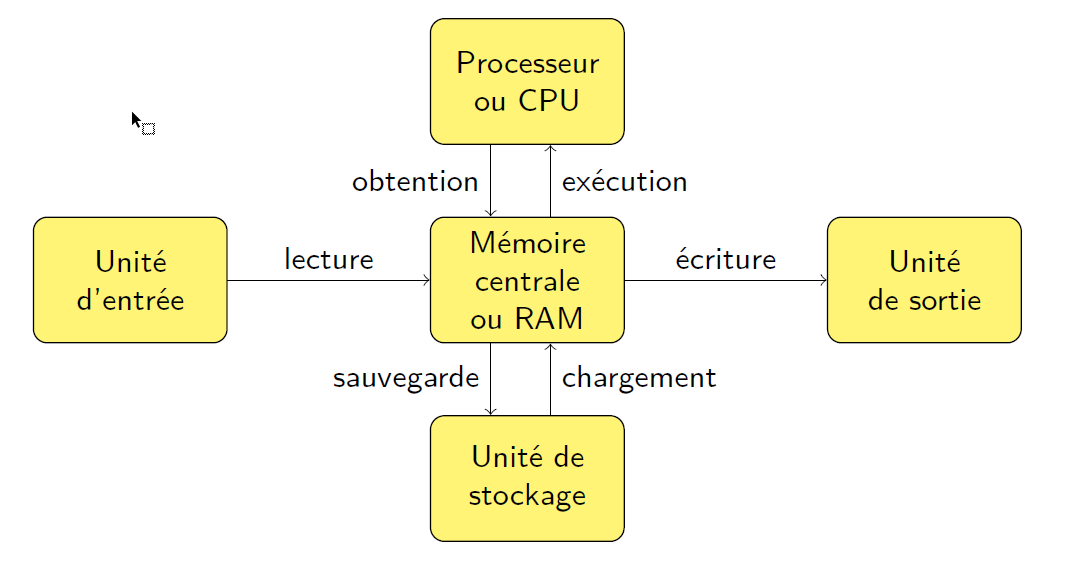
Voici une représentation de la façon dont fonctionne un ordinateur.
Unités d'entrées
- Clavier
- Souris
- Microphone
- Écran tactile
Unités de sortie
- Haut-parleur
- Écran / tactile
- Imprimante
Vue d'ensemble du stockage
- SSD (PCI E ou Sata)
- Disque dur
- Clé USB
- Carte SD
Mémoire centrale
La mémoire centrale contient les applications et le système d'exploitation (le logiciel qui gère l'ensemble des ressources de l'ordinateur — matériel, applications et interactions avec l'utilisateur). C'est elle qui gère le lancement, l'exécution et la sortie des programmes.
Mise en situation
Exécution de l'application Excel (imaginons qu'elle n'est pas en exécution actuellement) :
- La souris est utilisée pour cliquer sur l'application Excel dans la barre des tâches (lecture)
- Le logiciel doit être chargé du disque (car il doit être chargé en mémoire centrale)
- Le logiciel est exécuté par le processeur et est retourné en tant qu'application
- L'application est affichée par l'entremise du moniteur
- On modifie le document :
- Les unités d'entrées (clavier souris) occasionnent des lectures en mémoire centrale
- Les données sont modifiées en mémoire centrale et mises à jour par l'entremise du processeur (pour s'assurer de l'intégrité des données)
- Les données sont affichées par le moniteur
- On sauvegarde le document (L'utilisateur appuie sur le raccourci-clavier Ctrl-S)
- La mémoire lit l'information du clavier et sauvegarde le fichier sur une unité de stockage
Pièces de l'ordinateur
Le processeur
Le processeur est le véritable cerveau d'un PC. Il exécute les programmes ; son cycle de base est de lire une opération depuis la mémoire, la décoder, l'exécuter et l'écrire dans un registre ou dans la mémoire, et l'on continue pour les prochaines opérations. En anglais, CPU Central Processing Unit ou encore, en français, UCT (unité centrale de traitement). Il réalise les calculs arithmétiques, les comparaisons numériques, traite et transmet des données.
Un programme est écrit généralement dans un langage haut-niveau et sera compilé vers une architecture donnée. Pour vous donner un ordre de grandeur, un programme d'apparence simple comme la calculatrice de Windows (calc.exe) représente tout de même plusieurs milliers de lignes de code source, sans compter les librairies externes nécessaires à son fonctionnement. Une fois compilé en langage machine, le fichier exécutable contient un nombre bien plus grand d'instructions machine, puisque chaque ligne de code haut niveau se traduit généralement en plusieurs instructions machine.
Une distinction s'impose ici :
- le langage machine est un langage uniquement binaire que le processeur comprend et exécute.
- le langage assembleur est une version lisible par l'homme de ces instructions avec des noms symboliques comme MOV, ADD, JMP au lieu des chaînes de bits.
Intel et AMD sont les deux principaux manufacturiers pour les processeurs d'ordinateurs de bureau, ceux de portables et ceux de serveurs. Fait à noter, ce ne sont pas les mêmes modèles de processeur qui vont équiper les différents ordinateurs de bureau, les ordinateurs portables et les serveurs, chacun ayant sa spécificité.
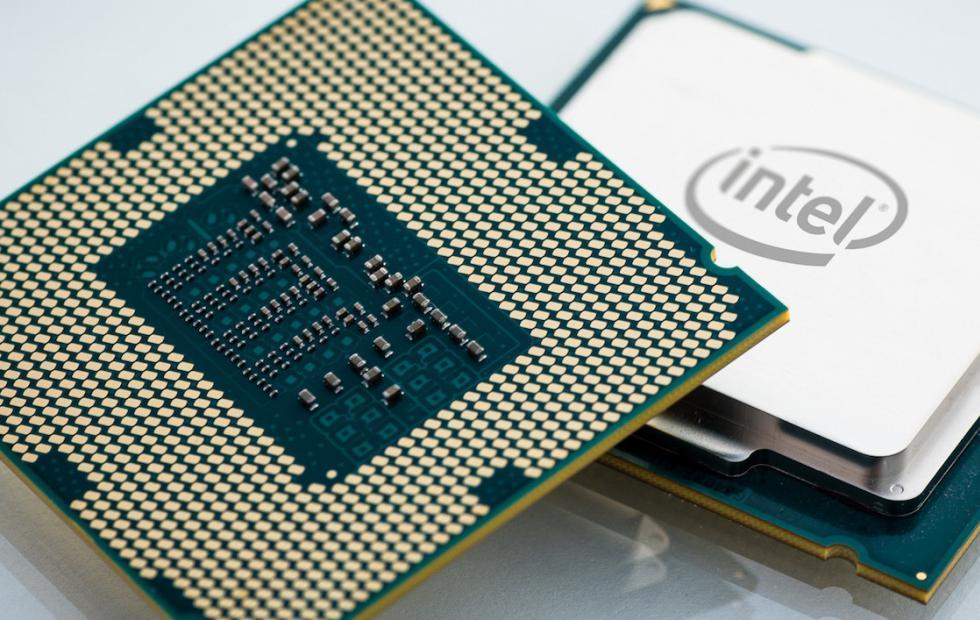
Alors qu'Apple, Samsung et Qualcomm le sont pour les appareils mobiles. Il est à noter que de plus en plus de manufacturiers chinois commencent à inonder le marché avec des processeurs à faible coût tels que Rockchip ou Mediatek.
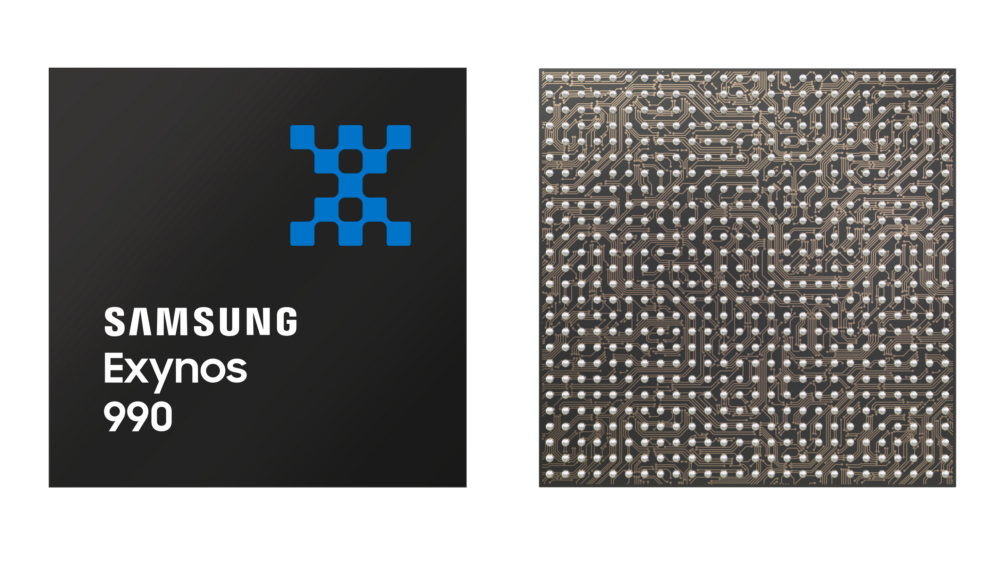
Exemple de puce mobile Samsung (illustration) — source : site de Samsung
Les processeurs actuels sont généralement petits et carrés avec plusieurs connecteurs métalliques en dessous. Les CPU se connectent à la carte-mère par l'entremise d'un socket qui permet d'y insérer le CPU.
Jeu d'instructions
Il s'agit de la liste d'instructions-machine que comprend un processeur en fonction du type d'architecture et du manufacturier. C'est un peu à cause de cette raison qu'un Intel x64 ne peut exécuter de code d'un ARMv7 : les listes d'instructions exécutables ne sont pas les mêmes.
Deux grandes familles de jeu d'instructions :
-
le CISC (Complex Instruction Set Computer) permet plusieurs instructions, voire des centaines dans le processeur. Mais un aussi grand nombre d'instructions rend les circuits électroniques du processeur complexes et plus les circuits sont complexes, plus long est le chemin à parcourir par le courant. Les architectures x86 et x64 se situent dans cette catégorie, cependant de nos jours, les processeurs optimisent les opérations complexes vers des opérations RISC simples.
-
le RISC (Reduced Instruction Set Computer) est une architecture permettant d'exécuter les mêmes types de tâches que l'architecture CISC, mais avec beaucoup moins d'instructions, voire moins d'une centaine. Ainsi, les circuits du processeur sont très simplifiés et donc, beaucoup plus rapides, mais moins performants. Les processeurs ARM et SPARC se retrouvent dans cette catégorie. Ceux-ci consomment moins de courant et sont utilisés dans les téléphones mobiles.
C'est la raison pour laquelle malgré le fait que les processeurs soient aussi rapides, les téléphones intelligents sont généralement moins performants que les ordinateurs de bureau.
Optimisation des processeurs
Processeurs hyperscalaires
Une possibilité afin d'améliorer la performance des processeurs est d'implanter plusieurs unités d'exécution :
- une pour l'arithmétique entière (virgule flottante)
- une pour les opérations logiques
- une pour les opérations arithmétiques
- et de disposer d'un buffer d'attente.
Plusieurs instructions sont lues, décodées et placées dans cette zone tampon (buffer) en attente d'être exécutées.
Hyperthreading
La loi de Moore (formulée par Gordon Moore en 1965, alors qu'il travaillait chez Fairchild Semiconductor — il ne cofondera Intel qu'en 1968) observe que le nombre de transistors d'un circuit intégré double environ tous les deux ans. Ce n'est pas une loi physique, mais une observation empirique.
Le problème, c'est qu'un seul thread ne réussit jamais à occuper en même temps toutes les unités d'exécution décrites plus haut : pendant qu'il attend une donnée en mémoire (ce qui peut prendre plusieurs cycles d'horloge), plusieurs unités d'exécution du cœur restent inactives. Dupliquer un cœur au complet (toutes ses unités d'exécution, son cache) pour régler ce gaspillage coûterait énormément de transistors. Or, la loi de Moore ne donne pas toujours assez de transistors neufs d'un coup pour se permettre ce luxe : les manufacturiers ont donc cherché une façon moins coûteuse d'exploiter les transistors additionnels.
L'hyperthreading est cette solution économique : plutôt que de dupliquer tout le cœur, on duplique seulement l'état d'un deuxième thread (ses registres, son pointeur d'instruction), ce qui ne demande qu'une fraction des transistors d'un cœur complet. Le cœur garde ainsi en mémoire les états de deux threads différents et peut passer de l'un à l'autre dans un laps de temps très court, de l'ordre de la nanoseconde, en utilisant les mêmes unités d'exécution. Concrètement, si un thread attend une donnée en mémoire, le cœur peut basculer vers le second thread pour combler les unités d'exécution qui seraient sinon restées inactives. C'est ainsi qu'Intel double le nombre de cœurs logiques par rapport au nombre de cœurs physiques, sans avoir à dupliquer un cœur en entier comme le fait le multicœur (voir plus bas).
Pourquoi seulement 2 threads logiques par cœur physique, et non 4 ou 8? C'est une question de rendements décroissants : le deuxième thread capture déjà la majorité des temps morts laissés par le premier, alors que chaque thread additionnel demande de dupliquer davantage d'état et augmente la contention sur le cache et les unités d'exécution partagées, pour un gain marginal de plus en plus faible. À l'époque du Pentium 4 (première génération d'Hyper-Threading), Intel présentait cette technologie comme pouvant améliorer sensiblement l'utilisation des unités d'exécution du cœur, sans toutefois publier de méthode de mesure précise pour ce gain. Ce n'est cependant pas une limite technique universelle : certains processeurs IBM POWER, par exemple, poussent jusqu'à 4 ou même 8 threads logiques par cœur, un choix justifié par des charges de travail serveur où le parallélisme disponible et la tolérance à la latence mémoire sont plus grands.
Multicœur
Au-delà du multithreading, on trouve des unités centrales possédant deux ou quatre processeurs intégrés complets. On dit de ces circuits qu'ils sont multicœurs. En séparant les processeurs en cœurs, on a augmenté le nombre d'instructions par seconde en multipliant le nombre de traitements en parallèle. Jusqu'au milieu des années 2000, les processeurs grand public étaient à cœur unique ; le Pentium 4 est emblématique de cette dernière génération avant la transition généralisée vers le multicœur, bien qu'Intel ait continué à vendre certains modèles d'entrée de gamme à cœur unique (Celeron, Atom) pendant encore plusieurs années. On peut dire aujourd'hui que, mis à part quelques circuits intégrés de faible puissance, les processeurs à cœur unique ont pratiquement disparu du marché grand public.
Cœurs hybrides (P-cores / E-cores)
Intel a introduit cette approche en 2021 avec ses processeurs Alder Lake, alors qu'Apple l'utilisait déjà depuis ses puces A-series et M1 : plutôt que d'avoir des cœurs tous identiques, le processeur combine deux types de cœurs :
- Les cœurs de performance (P-cores) : optimisés pour exécuter une tâche unique le plus rapidement possible.
- Les cœurs d'efficacité (E-cores) : plus petits et moins gourmands, optimisés pour exécuter plusieurs tâches légères en parallèle (tâches d'arrière-plan par exemple).
C'est le système d'exploitation (par exemple via Intel Thread Director sous Windows) qui décide quel type de cœur doit exécuter quelle tâche, selon sa priorité et le besoin en puissance.
Architecture en chiplets (tuiles)
Plutôt que de graver un processeur en un seul grand morceau de silicium (monolithique), les manufacturiers assemblent désormais plusieurs petites puces spécialisées (chiplets, ou « tuiles ») reliées ensemble dans un même boîtier :
- AMD utilise cette approche depuis ses processeurs Ryzen (Zen 2 et plus), avec des chiplets de cœurs séparés du chiplet d'entrées-sorties.
- Intel l'a adoptée avec ses puces Core Ultra (Meteor Lake), qui séparent les tuiles de calcul, de graphique, d'E/S et de connectivité.
De plus petites puces offrent un meilleur rendement de fabrication (moins de défauts par puce), et chaque tuile peut être gravée avec le procédé le plus approprié à sa fonction plutôt que d'utiliser le même procédé coûteux pour tout le processeur.
Cache empilé verticalement (3D V-Cache)
AMD a introduit avec ses processeurs Ryzen X3D une technique qui empile une couche de mémoire cache L3 directement au-dessus du die du processeur plutôt que de l'étendre horizontalement. Cela permet d'augmenter considérablement la taille du cache disponible (donc de réduire les accès à la RAM, plus lente) sans agrandir la surface du processeur, une technique particulièrement populaire pour les jeux vidéo, très sensibles à la taille du cache.
Intégration poussée de fonctionnalités IA
-
Les CPU intègrent désormais des accélérateurs dédiés à l’intelligence artificielle (IA), capables d’exécuter des billions d’opérations par seconde, destinés à optimiser les performances automatiques, le traitement du langage, la vision, etc.
-
Intel mise sur le concept de « PC IA » en rendant les processeurs capables de gérer nativement de nombreuses fonctions IA.
-
Ils sont généralement intégrés dans le même silicium que le CPU principal au sein du processeur, souvent appelés NPU (Neural Processing Unit) ou accélérateurs IA dédiés.
-
Par exemple, Intel a intégré un NPU dans ses puces Core Ultra (à partir de Meteor Lake), AMD a lancé ses processeurs Ryzen avec unités IA (XDNA). Apple, de son côté, intègre un moteur neuronal (Neural Engine) depuis ses premières puces M1 (2020) et A11 (2017), bien avant cette tendance chez Intel et AMD, et continue de l'améliorer dans les puces suivantes jusqu'aux M5 et M6 (2025-2026), ce dernier introduisant un double Neural Engine (deux moteurs de 16 cœurs).
-
Ces unités spécialisées travaillent en parallèle avec les cœurs CPU classiques (P et E cores) pour effectuer rapidement les algorithmes IA sans surcharger le CPU général.
-
Ces composants sont souvent couplés avec la mémoire cache du CPU pour un accès rapide aux données nécessaires aux calculs IA.
Combien de puissance IA cela représente-t-il?
On mesure la puissance d'un NPU en TOPS (Tera Operations Per Second), soit 10^12 (mille milliards) d'opérations par seconde. Quelques exemples actuels :
| Puce | NPU | Puissance |
|---|---|---|
| Apple M4 | Neural Engine (16 cœurs) | 38 TOPS |
| Apple M5 | Neural Engine (16 cœurs) | ~42 TOPS |
| Apple M6 | Double Neural Engine (2 x 16 cœurs) | ~2x le M5 (Apple ne publie plus de chiffre TOPS officiel exact, seulement des comparaisons relatives) |
| AMD Ryzen AI 300 (Strix Point) | XDNA 2 | 50 TOPS |
| Intel Core Ultra 200V (Lunar Lake) | NPU 4 | 48 TOPS |
Exemple illustratif (ordre de grandeur, pas une mesure officielle) : supposons qu'un modèle léger de reconnaissance d'image nécessite environ 4 milliards d'opérations (4 GOPS) par image analysée. Avec un NPU de 38 TOPS (Apple M4) :
38 000 000 000 000 ÷ 4 000 000 000 = 9500 images par seconde, en théorie (sans tenir compte des limites de mémoire ou de transfert de données).
C'est ce niveau de puissance qui permet d'exécuter toutes sortes de modèles d'IA directement sur l'appareil, en temps réel et sans surcharger le CPU ni dépendre d'une connexion internet. Quelques exemples concrets :
- Floutage d'arrière-plan et recadrage automatique lors d'un appel vidéo : un modèle de segmentation isole la personne de son environnement, pixel par pixel, et peut même garder la caméra centrée sur elle si elle se déplace.
- Suppression du bruit de fond en direct sur le micro : le modèle apprend à distinguer une voix humaine du reste (clavier, chien, circulation) et ne transmet que la voix.
- Sous-titrage et traduction de la parole en temps réel, y compris hors ligne, sans envoyer l'audio à un serveur distant.
- Retouche ou génération d'image sur l'appareil (agrandissement intelligent d'une photo, remplissage génératif d'une zone effacée) sans passer par le cloud.
Efficacité énergétique et gestion thermique améliorées
-
Gravure avec procédés avancés (3 nm, 4 nm, bientôt 2 nm en développement).
-
Gestion dynamique plus fine de la fréquence et du voltage pour réduire la consommation et le dégagement thermique.
-
Refroidissement souvent optimisé et intégré dans les puces.
Puces Apple Silicon et architecture SoC
Depuis 2020, Apple a abandonné les processeurs Intel (x86) pour ses propres puces ARM (M1 à M6). Celles-ci illustrent bien la tendance actuelle vers l'intégration poussée :
- Le CPU, le GPU, la mémoire vive et le moteur neuronal (Neural Engine, l'équivalent du NPU) sont soudés sur une seule puce, appelée System on a Chip (SoC).
- La mémoire est dite « unifiée » : le CPU et le GPU partagent la même RAM physique, ce qui évite les copies de données entre les deux et améliore la performance.
- Puisque la RAM est soudée sur la puce, elle ne peut pas être ajoutée ou remplacée après l'achat sur ces appareils.
- Cette intégration permet une excellente efficacité énergétique, au prix d'une flexibilité de mise à niveau réduite comparée à un PC de bureau traditionnel.
Propriétés des processeurs
Cadence
La vitesse d'un processeur se détermine par le nombre d'instructions effectuées par seconde :
Imaginons un processeur à 1 hertz, ce dernier ferait une instruction par seconde, alors qu'un processeur à 3 GHz peut exécuter 3 milliards d'opérations par seconde.
Recherche d'information
Lorsque l'information recherchée n'est pas dans les registres, le processeur devra se tourner vers ses caches. Ils sont généralement au nombre de trois identifiés comme L1 / L2 / L3. La taille de ses registres est calculée en MB et varie selon le type de processeur.
Les niveaux sont de vitesse décroissante et de taille croissante. Donc le L1 est généralement très petit, mais excessivement rapide, le L2 est plus lent, mais dispose de plus de données.
Finalement, chaque cœur a accès à son propre L1 et L2, mais généralement le L3 est partagé entre tous les cœurs.
Comment obtenir toute l'information des processeurs?
Dans la page de présentation du processeur (que ce soit Intel ou AMD), nous pouvons voir les spécificités.
Par exemple, le i9-14900K a :
- 24 cœurs physiques (8 cœurs à haute performance, 16 cœurs à haute efficacité énergétique)
- 32 cœurs logiques (donc hyperthreading)
- Socket : LGA1700 (microarchitecture Raptor Lake Refresh)
- Gravure : Intel 7 (10 nm amélioré)
- TDP nominal de 125 W avec un TDP turbo jusqu'à 253 W.
- Cache L3 de 36 Mo et L2 de 32 Mo.
- Vitesse : 6 GHz (vitesse de chacun des cœurs)
Notez que depuis 2024, Intel a remplacé l'appellation « Core i9 » par « Core Ultra 9 » pour ses nouvelles générations (Arrow Lake, ex. Core Ultra 9 285K) — fait notable, ces nouvelles générations ont abandonné l'hyperthreading (24 cœurs physiques = 24 cœurs logiques, sans démultiplication).
Nos téléphones cellulaires sont équipés de multiples cœurs également, par exemple le A18 d'Apple (iPhone 16) possède 2 cœurs performants et 4 cœurs économes, qui se partagent la tâche selon le besoin de puissance ou d'autonomie.
En tant que développeur
Les notions importantes à savoir sont les suivantes :
-
Si vous créez un programme et que vous souhaitez qu'il utilise plus de « cœurs », vous devrez le coder en ce sens. Par défaut, un programme ne s'exécute que sur un cœur.
-
Le système d'exploitation gère l'assignation des opérations à faire au processeur. Votre programme peut se faire interrompre n'importe quand par un processus plus prioritaire, une requête utilisateur, ...
Carte-mère
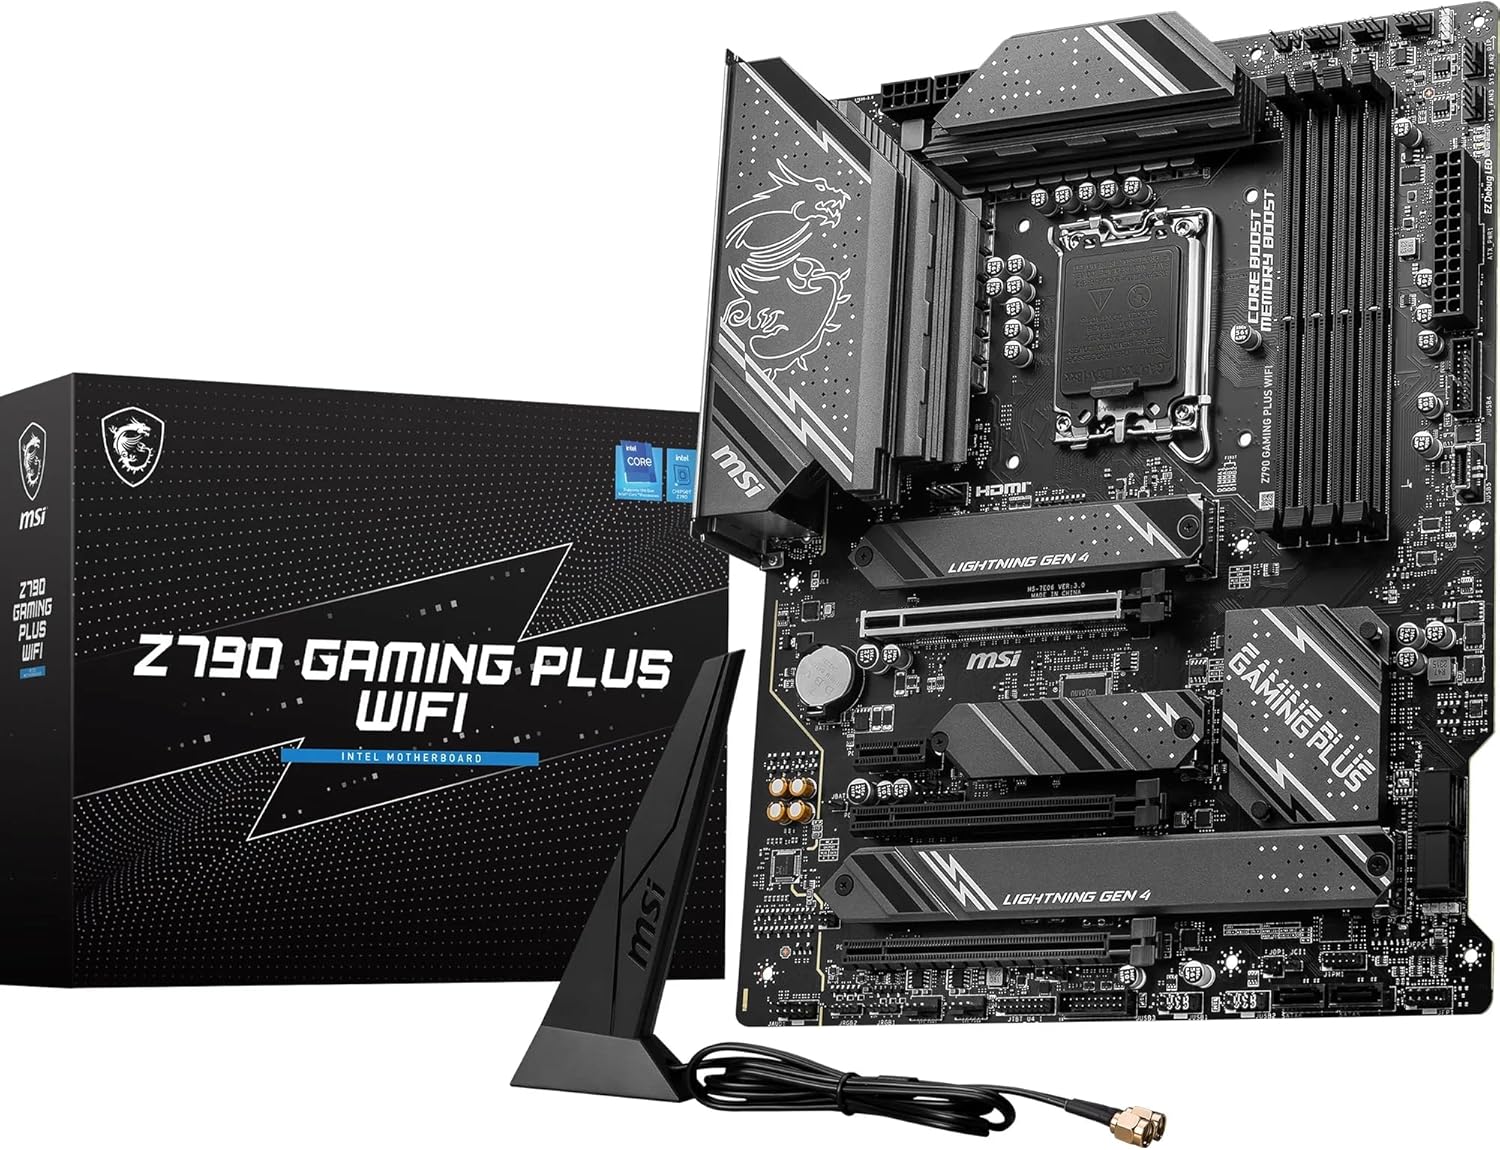
L'élément constitutif principal de l'ordinateur personnel est la carte-mère, aussi appelée « Motherboard » ou « Mainboard ». La carte-mère d'un PC contient une multitude de circuits intégrés et chacun de ces circuits joue un rôle particulier.
C'est sur cette carte que l'on connecte le processeur, la mémoire RAM (mémoire centrale), les disques durs ou SSD et la carte graphique. Il est à noter que chaque carte-mère est différente, elle n'est compatible qu'avec un certain chipset de CPU par l'entremise du type de socket utilisé.
Ports
Les ports à l'arrière de la carte-mère sont :
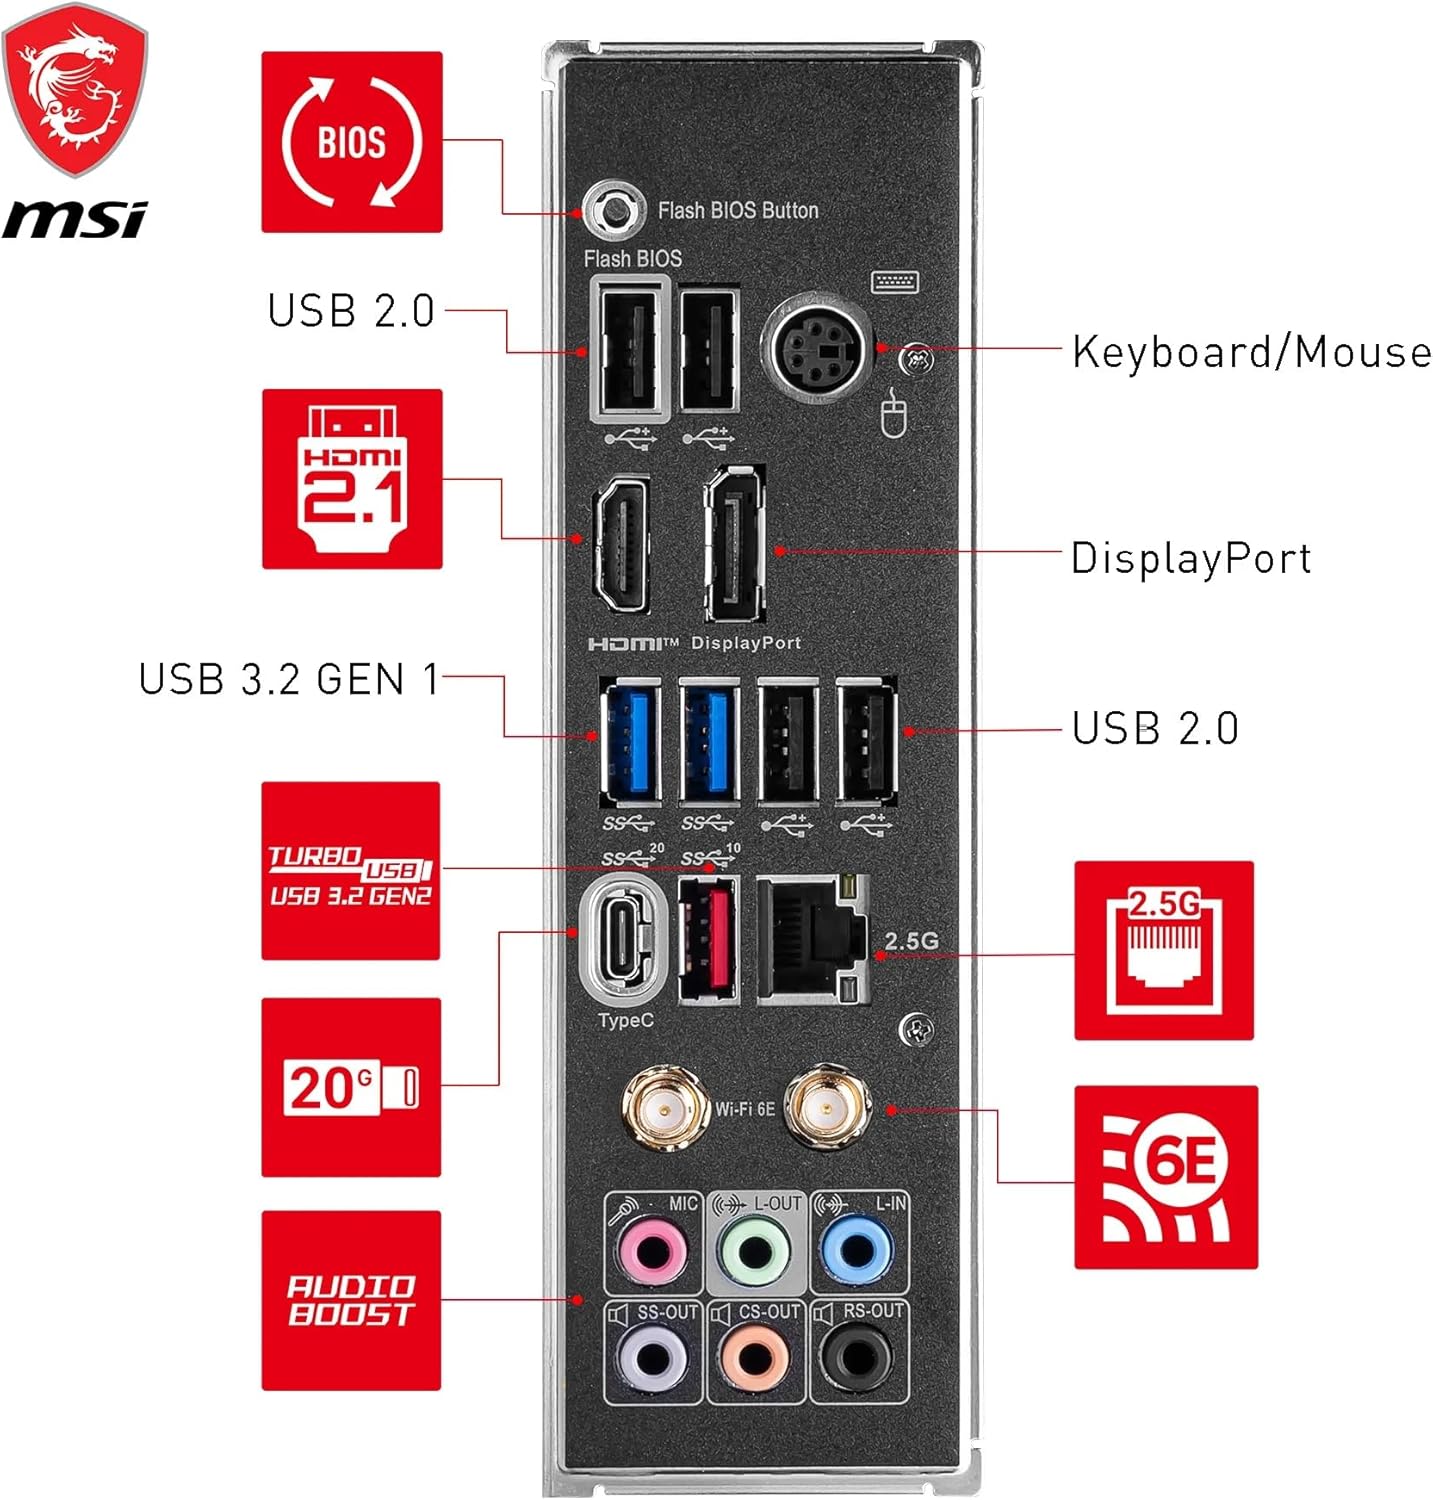
- USB (2.0/3.x, souvent identifiable par un code de couleur qui varie selon les fabricants) et USB-C
- Ethernet (interface RJ-45) 2.5 Gbps
- Antennes WIFI
- Sortie son (Surround) et Microphone
- HDMI et Display Port
Fentes d'extension
- PCI Express: Généralement les cartes graphiques utilisent la ou les fentes d'extensions principales.
- Les fentes d'extension 1X peuvent être utilisées à d'autres fins: réseau (fibre optique), SATA, RAID, Wi-Fi, SSD.
- M.2 : Généralement utilisé pour les unités de stockage ; les vitesses varient largement selon la génération PCI Express utilisée (voir la section Unité de stockage plus loin).
- SATA : Plus ancien, permet de connecter les disques durs rotatifs et certains SSDs. Offre des vitesses jusqu'à 600 MB/s.
Bien que l'on parle généralement de carte-mère pour les ordinateurs de bureau, tous les appareils électroniques — cellulaire, tablette, portable — possèdent l'équivalent d'une carte-mère. La principale distinction est que, pour ces appareils miniatures, les éléments sont soudés directement dessus :
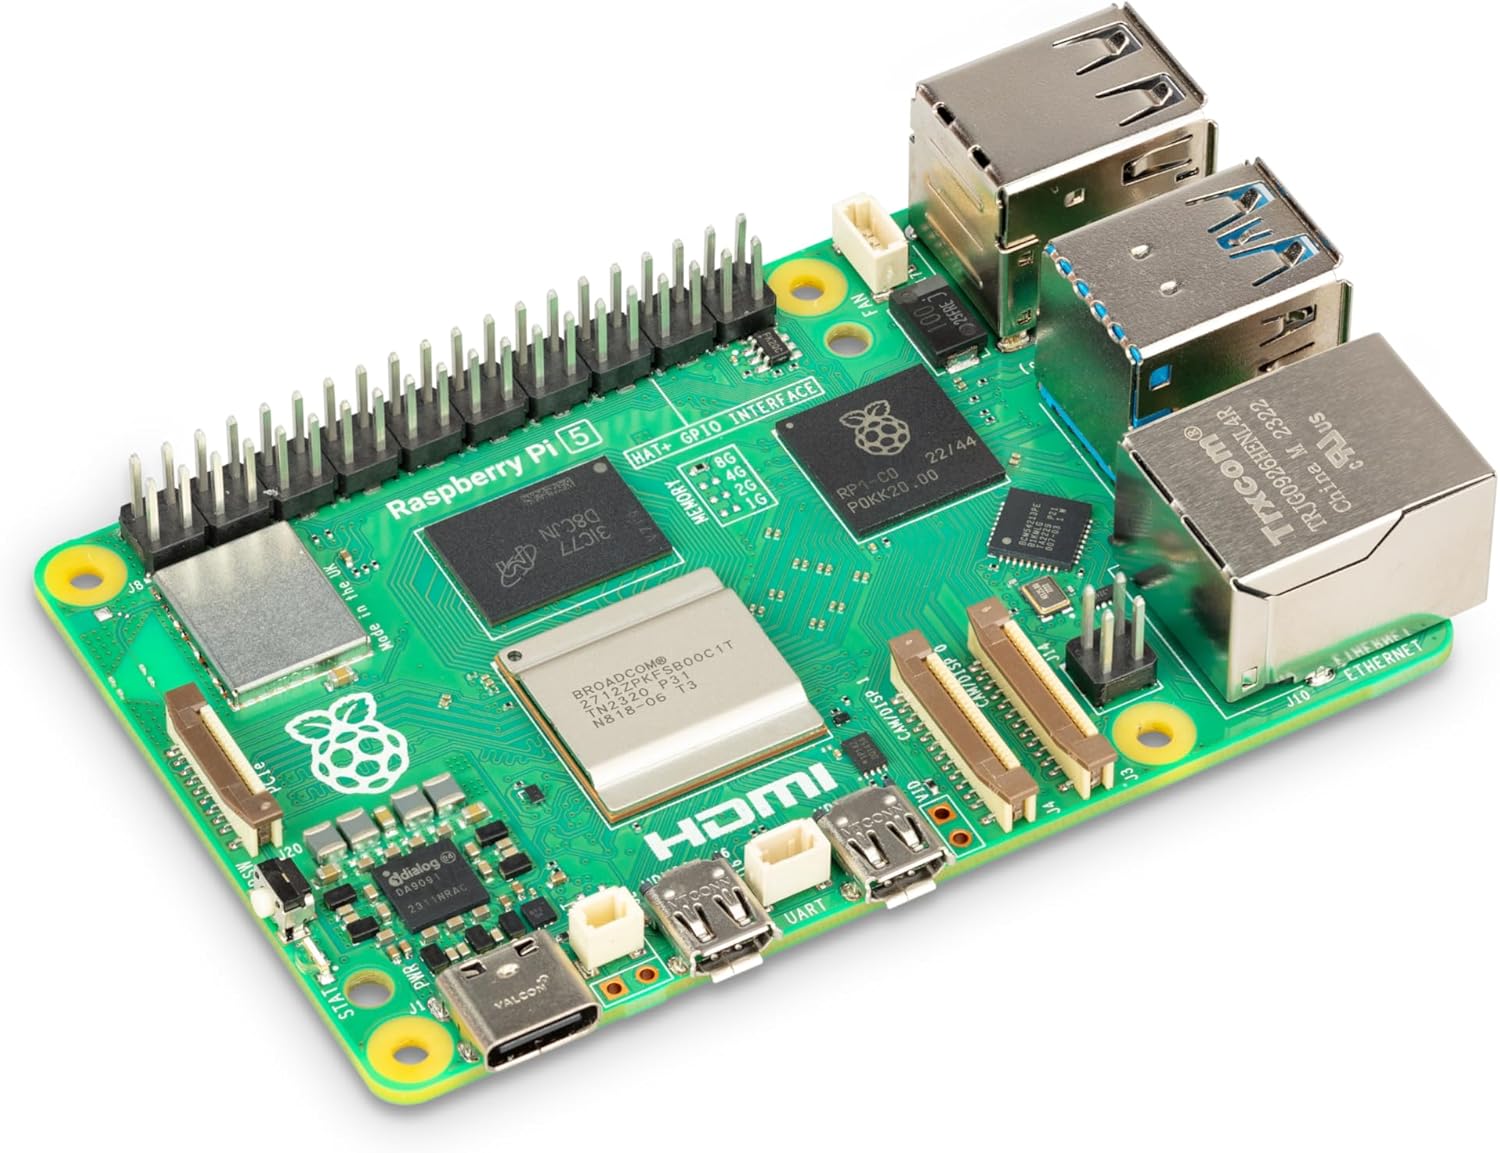
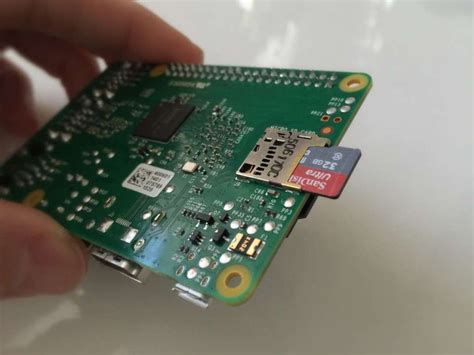
Comme vous le voyez ici, un Raspberry Pi est un ordinateur qui tient sur une petite carte de la taille d'une carte de crédit. Il est généralement utilisé dans les projets de DIY (do it yourself) d'automatisation. Une carte SD ou une clé USB peut être utilisée pour stocker le système d'exploitation.
Chipset
Un chipset est un ensemble de circuits intégrés situés sur la carte-mère d’un ordinateur, dont le rôle principal est de gérer et coordonner le flux de données entre le processeur, la mémoire vive, les dispositifs de stockage, les cartes graphiques et les autres périphériques connectés.
Composition traditionnelle
Historiquement, le chipset était divisé en deux parties :
-
Northbridge : gère les communications rapides entre processeur, RAM et GPU.
-
Southbridge : gère les périphériques d’entrée/sortie moins rapides (USB, audio, SATA, réseau).
De nos jours, beaucoup de fonctions du Northbridge sont intégrées directement dans le CPU, et le chipset gère principalement les fonctions du Southbridge.
Comme nous le démontre le schéma suivant :
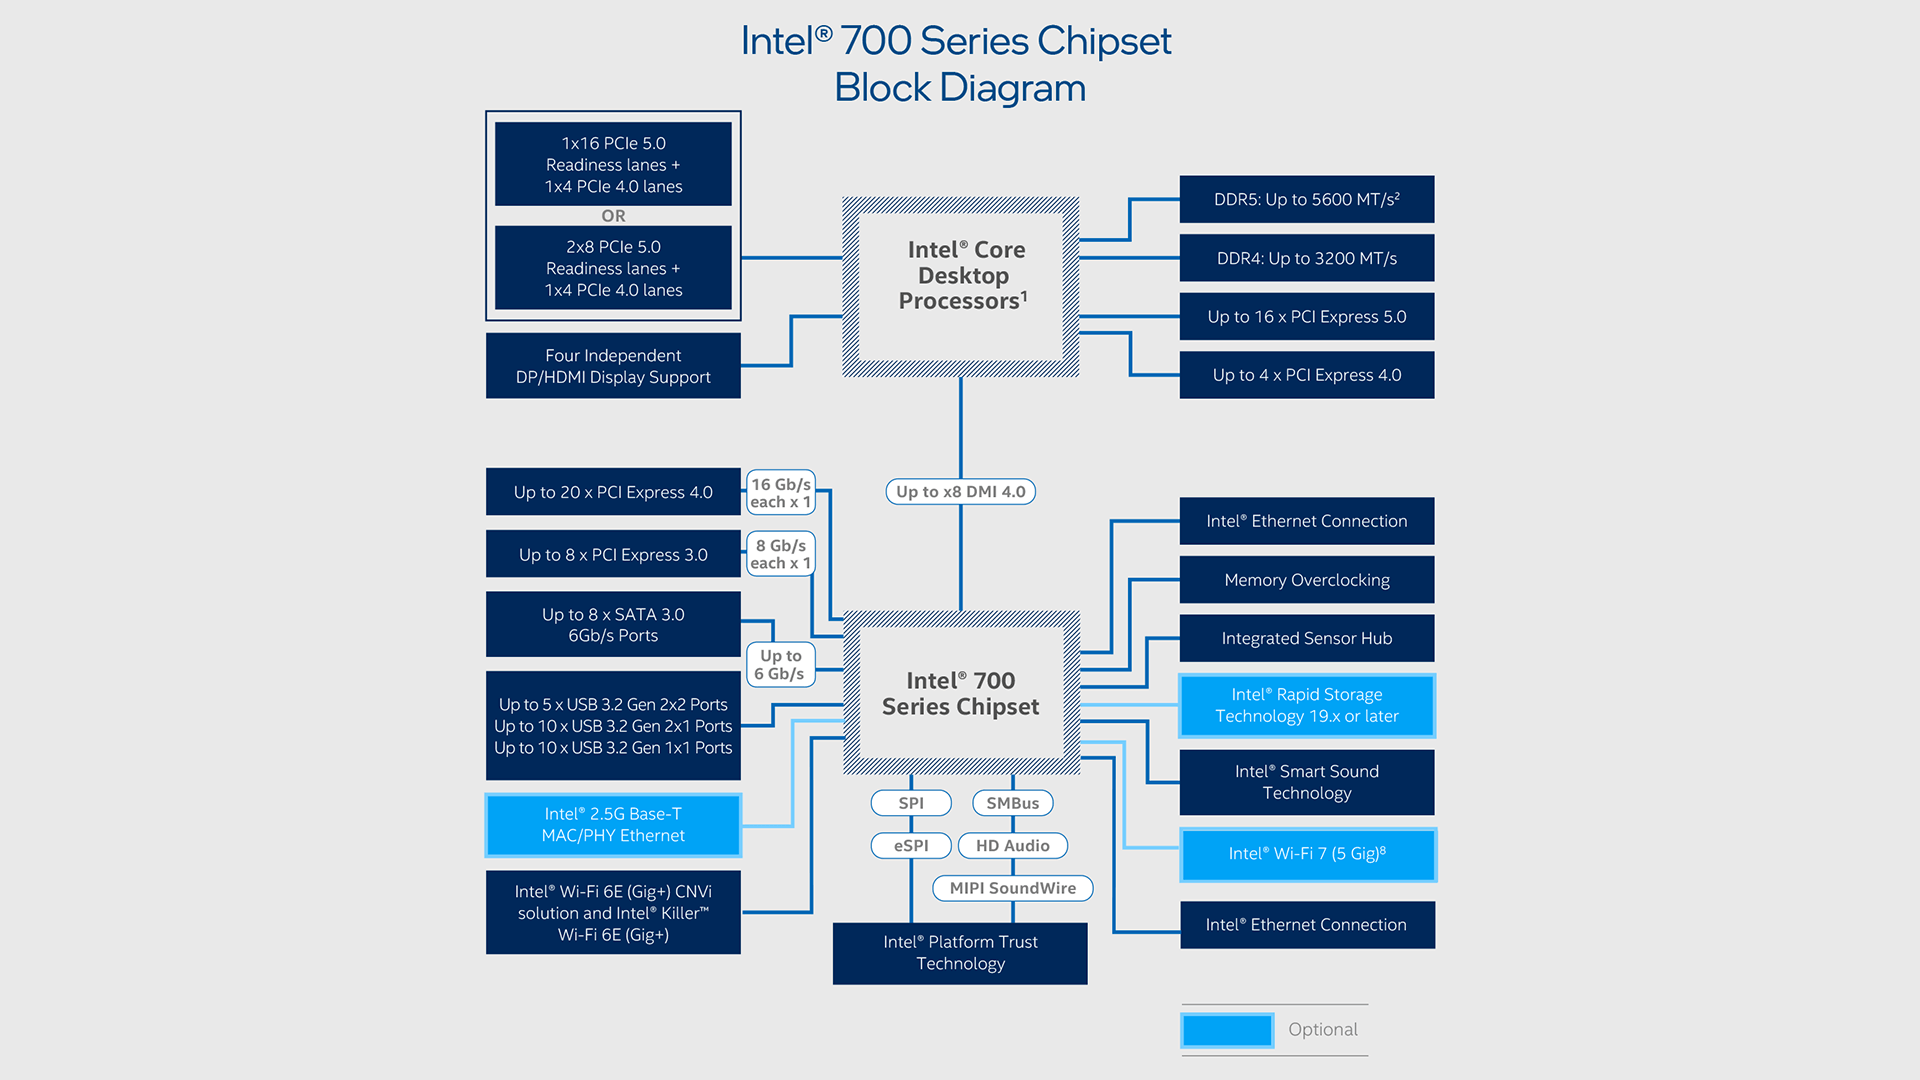
Comprenez que ce qui nécessite une grande vitesse sera directement géré par le processeur alors que ce qui nécessite moins de vitesse passera par le chipset (carte-mère). Avec ce schéma, le processeur communique directement avec la mémoire centrale RAM, le PCI Express ou SSD et le Display Port / HDMI. Lorsque la vitesse n'est pas nécessaire, nous utilisons le chipset soit pour :
- le son
- les ports SATA
- les ports USB
- le réseau ethernet ou wifi
- les ports PCI Ex 1x moins rapides.
Les fentes PCI Express existent en plusieurs tailles (16X, 8X, 4X, 1X) selon le nombre de voies qu'elles offrent :
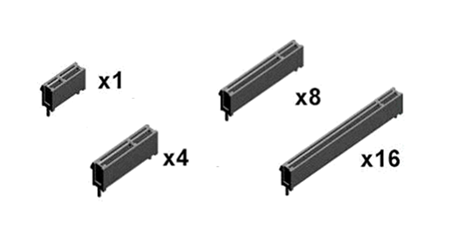
Le CPU ne prend en charge qu'un nombre total limité de voies PCI Ex (par exemple 16x, ou 2x 8x, ou 1x 8x + 2x 4x) : si vous installez deux cartes vidéo, elles se partageront ces voies (8x chacune) et performeront donc moins rapidement. Ces voies gérées directement par le CPU sont plus rapides que celles offertes par le chipset; un port M.2 utilise d'ailleurs souvent 4 voies PCI Ex pour atteindre ses hautes vitesses.
Du côté AMD, le diagramme est relativement similaire :
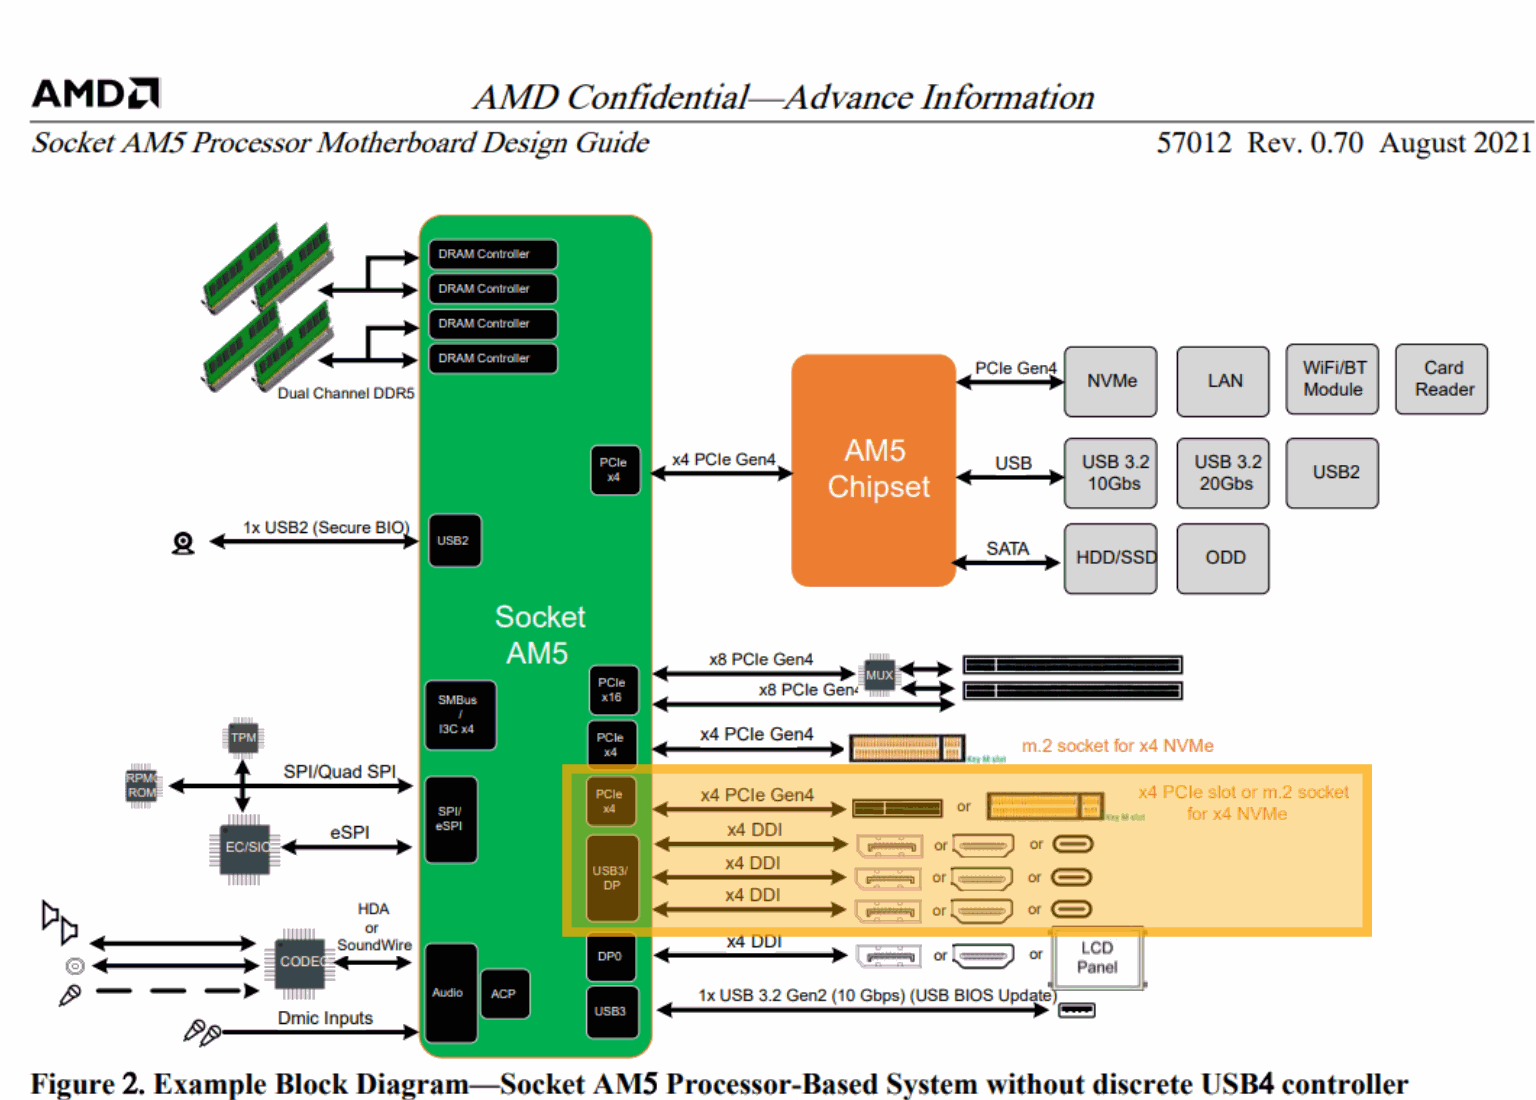
Le chipset ici est le X670 chez AMD qui communique avec les processeurs de la série Ryzen 9000 (nom de code Granite Ridge).
Finalement, l'emplacement de la carte-mère où l'on insère le processeur est nommé socle (ou socket en anglais).
Vous comprendrez que lorsque vous assemblez un ordinateur, vous devrez vous assurer que le socle (socket) soit compatible avec votre processeur.
BUS
Un bus est une route entre deux éléments : entre le processeur et la mémoire centrale, un bus; entre le socket et le USB, un bus. À l'origine des ordinateurs, un seul bus partagé était utilisé pour toutes les communications, mais avec l'augmentation des performances (tant pour les E/S que pour la communication entre processeur et mémoire), on s'est tourné vers des bus spécialisés et de plus en plus rapides — comme le DMI et le QPI que l'on voit dans les diagrammes précédents chez Intel, ou l'Infinity Fabric chez AMD.
Mémoire vive
Le processeur, comme mentionné précédemment, effectue les calculs et traite les données. Mais celui-ci ne peut pas emmagasiner l'information... il ne peut utiliser les registres que comme cache temporaire.
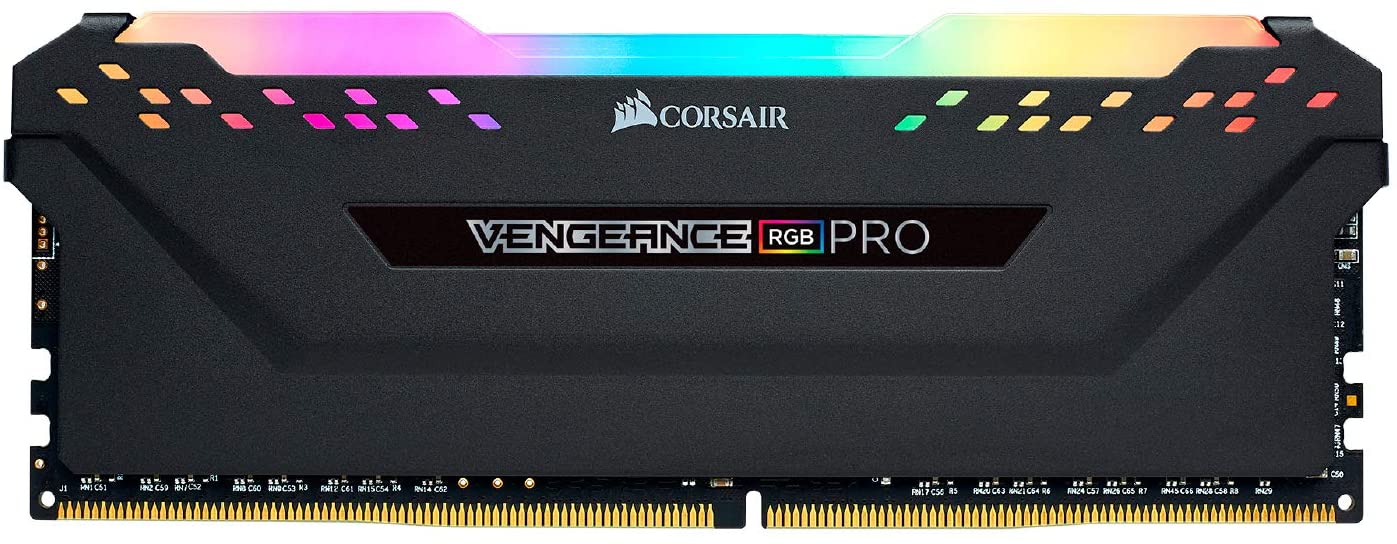
Qui s'occupe de contenir la mémoire des programmes?
La mémoire centrale ou mémoire RAM (Random Access Memory), mémoire à accès aléatoire, est souvent appelée « mémoire vive ». Il s'agit en fait de mémoire temporaire pour les données. Elle nécessite un courant électrique constant : lorsque le PC est mis hors tension, tout le contenu de la mémoire RAM est remis à zéro.
Chaque fois qu'un programme est exécuté sur un PC, celui-ci est emmagasiné dans la mémoire vive puis traité par le processeur. Nous verrons pourtant qu'il existe de la mémoire de stockage sous plusieurs formes.
Pourquoi avons-nous donc besoin de mémoire centrale?
Il s'agit d'une question de rapidité. La mémoire de stockage est réputée pour son utilité, mais aussi pour sa lenteur. En appliquant la loi du troupeau, les éléments d'un PC interagissent entre eux et la vitesse des échanges est déterminée par la composante la plus lente. Le processeur étant extrêmement rapide, il est donc préférable de l'utiliser avec une composante des plus rapides.
GPU
Le GPU ou carte vidéo (graphique) ou graphic processing unit est une carte d'extension permettant de générer une image sur un écran. Certains processeurs ont une carte vidéo intégrée, c'est le cas de la majorité des processeurs Intel résidentiels, donc lors de l'assemblage d'un ordinateur à processeur Intel, il n'est pas nécessaire de se procurer absolument une carte graphique. Bien sûr que les cartes graphiques intégrées ne sont pas au même niveau que les cartes graphiques externes lorsqu'on parle de performance dans les jeux vidéo, mais pour un usage traditionnel, elles sont malgré tout performantes.
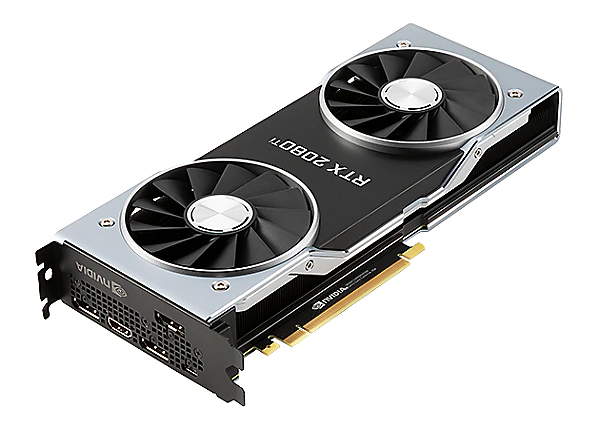
Présentement il y a deux manufacturiers principaux pour les ordinateurs de bureau ou portable : Nvidia et AMD. Du côté mobile, Qualcomm (Adreno) et Nvidia proposent des GPU pour les mobiles (cellulaire et tablettes). Les Chinois ont des GPU également, Mali. Du côté libre, VideoCore de Broadcom équipe le Raspberry PI.
Les GPU servent à générer ou manipuler des images à afficher sur un écran. Leur architecture, composée de milliers de petits cœurs de calcul, leur permet d'effectuer une même opération simultanément sur un grand nombre de données (calcul massivement parallèle) — contrairement au CPU, optimisé pour peu de tâches complexes exécutées rapidement l'une après l'autre. C'est ce qui les rend plus rapides que le CPU pour des tâches comme :
- Le rendu 3D et l'affichage de jeux vidéo (calculer la couleur de millions de pixels en parallèle).
- L'encodage et le décodage vidéo (compression/décompression accélérée matériellement).
- L'entraînement et l'exécution de modèles d'intelligence artificielle (multiplications de matrices massivement parallèles).
- Le minage de cryptomonnaie et certains calculs scientifiques (simulations, calcul distribué) qui se prêtent bien au parallélisme.
Les ordinateurs portables utilisent plusieurs GPU, un qui sera intégré au processeur pour une question d'économie d'énergie et s'occupera des calculs 2D et un plus performant, externe, qui sera rattaché au système et qui s'occupera du calcul 3D, mais qui viendra avec sa consommation électrique plus élevée.
Le GPU possède également sa propre mémoire vive sur la carte, appelée VRAM (Video RAM), permettant ainsi au processeur graphique de faire ses calculs sans dépendre de la RAM principale du système. Certaines cartes vont venir avec de la DDR traditionnelle alors que d'autres vont bénéficier de GDDR.
La différence entre les deux est que la GDDR est utilisée pour transporter de larges quantités de données simultanément grâce à un bus de données plus large (entre le GPU et la VRAM sur la carte vidéo).
Cette VRAM dédiée est le modèle traditionnel des GPU externes. C'est justement ce que la mémoire unifiée des puces Apple Silicon (voir plus haut, section SoC) vient remplacer : plutôt qu'une VRAM séparée pour le GPU et une RAM séparée pour le CPU, les deux processeurs partagent la même mémoire physique.
Dernièrement, une grande portion de la consommation électrique d'un ordinateur provient de la carte graphique ; parfois, une simple modification de la carte graphique occasionne un changement du bloc d'alimentation (Power Supply).
Power Supply
Le power supply est le convertisseur de courant entre le courant alternatif provenant du mur et le courant continu utilisé pour alimenter les différentes portions de l'ordinateur. Il existe 3 types, selon que les câbles sont amovibles ou non : modulaire, semi-modulaire et non modulaire.
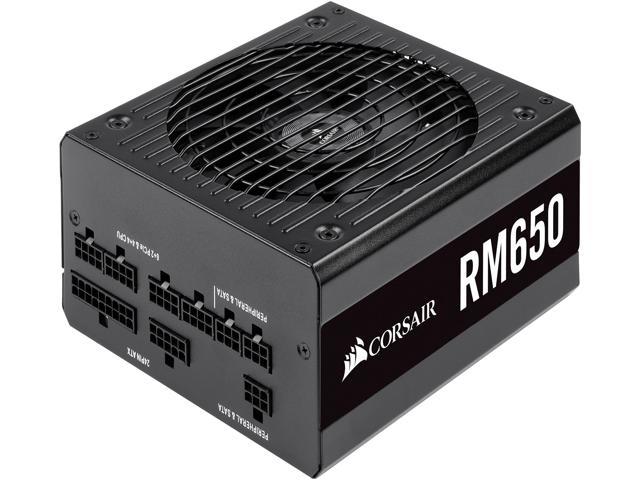
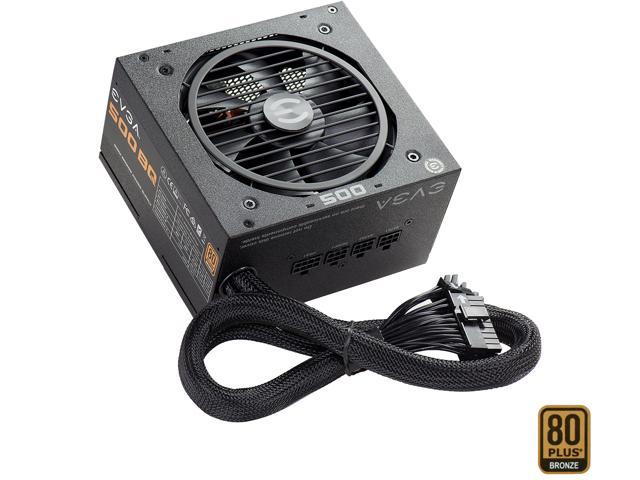
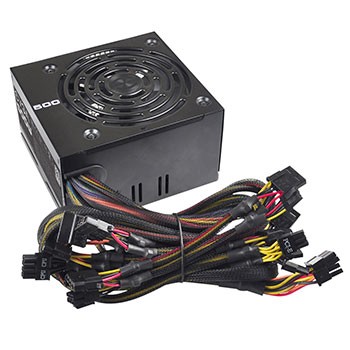
La qualité d'un power supply se mesure aussi par sa certification d'efficacité, du moins bon au meilleur : 80 PLUS, Bronze, Silver, Gold, Platine, Titane.

source: https://www.velocitymicro.com/blog/what-is-psu-efficiency-and-why-is-it-important/
Qu'est-ce que ceci implique?
La conversion du courant alternatif en courant continu entraîne toujours une perte d'énergie, d'autant plus faible que la certification est élevée (titane/platine). Cette perte augmente aussi lorsqu'on s'approche de 100 % de la capacité utilisée. Gardez donc un tampon d'alimentation pour rester entre 40 % et 60 % de la capacité du power supply : cela laisse de la marge pour ajouter des composants plus tard et protège le reste de l'ordinateur.
Refroidissement
Un processeur qui chauffe trop réduit automatiquement sa vitesse pour se protéger (throttling), voire s'éteint dans les cas extrêmes. Le refroidissement sert à évacuer la chaleur générée par le CPU (et le GPU) vers l'air ambiant.
Refroidissement à air
Le plus commun : un dissipateur en métal (souvent en cuivre ou aluminium, parfois avec des caloducs) posé directement sur le processeur, muni d'un ou plusieurs ventilateurs pour évacuer la chaleur accumulée. Une fine couche de pâte thermique est appliquée entre le processeur et le dissipateur pour éliminer les micro-interstices d'air, mauvais conducteurs de chaleur.
Refroidissement liquide (AIO / watercooling)
Un liquide caloporteur circule entre une plaque en contact avec le processeur et un radiateur externe (souvent couplé à des ventilateurs), où la chaleur est dissipée. Les kits « AIO » (All-In-One), vendus préassemblés et scellés, sont les plus courants; les circuits « custom » (assemblés pièce par pièce par l'utilisateur) offrent de meilleures performances mais sont plus complexes à installer et à entretenir.
Le refroidissement liquide est généralement plus performant et plus silencieux que le refroidissement à air pour un même budget, mais coûte plus cher et introduit un (faible) risque de fuite.
Sur les appareils compacts
Sur les téléphones, tablettes et certains portables ultra-minces, il n'y a souvent pas de ventilateur : la chaleur est dissipée passivement par le boîtier lui-même (parfois à l'aide d'une chambre à vapeur), ce qui limite la performance soutenue de ces appareils comparativement à un ordinateur de bureau qui peut se permettre un refroidissement actif plus imposant.
Unité de stockage
Il en existe plusieurs types ; voyons-les en ordre de taille :
Disque dur rotatif
Nommé en anglais HDD (hard disk drive), vieillissant mais toujours disponible, il s'agit des disques à plateaux sur lesquels les données sont inscrites, sur les différents plateaux ou disques, dans leur boîtier hermétique.
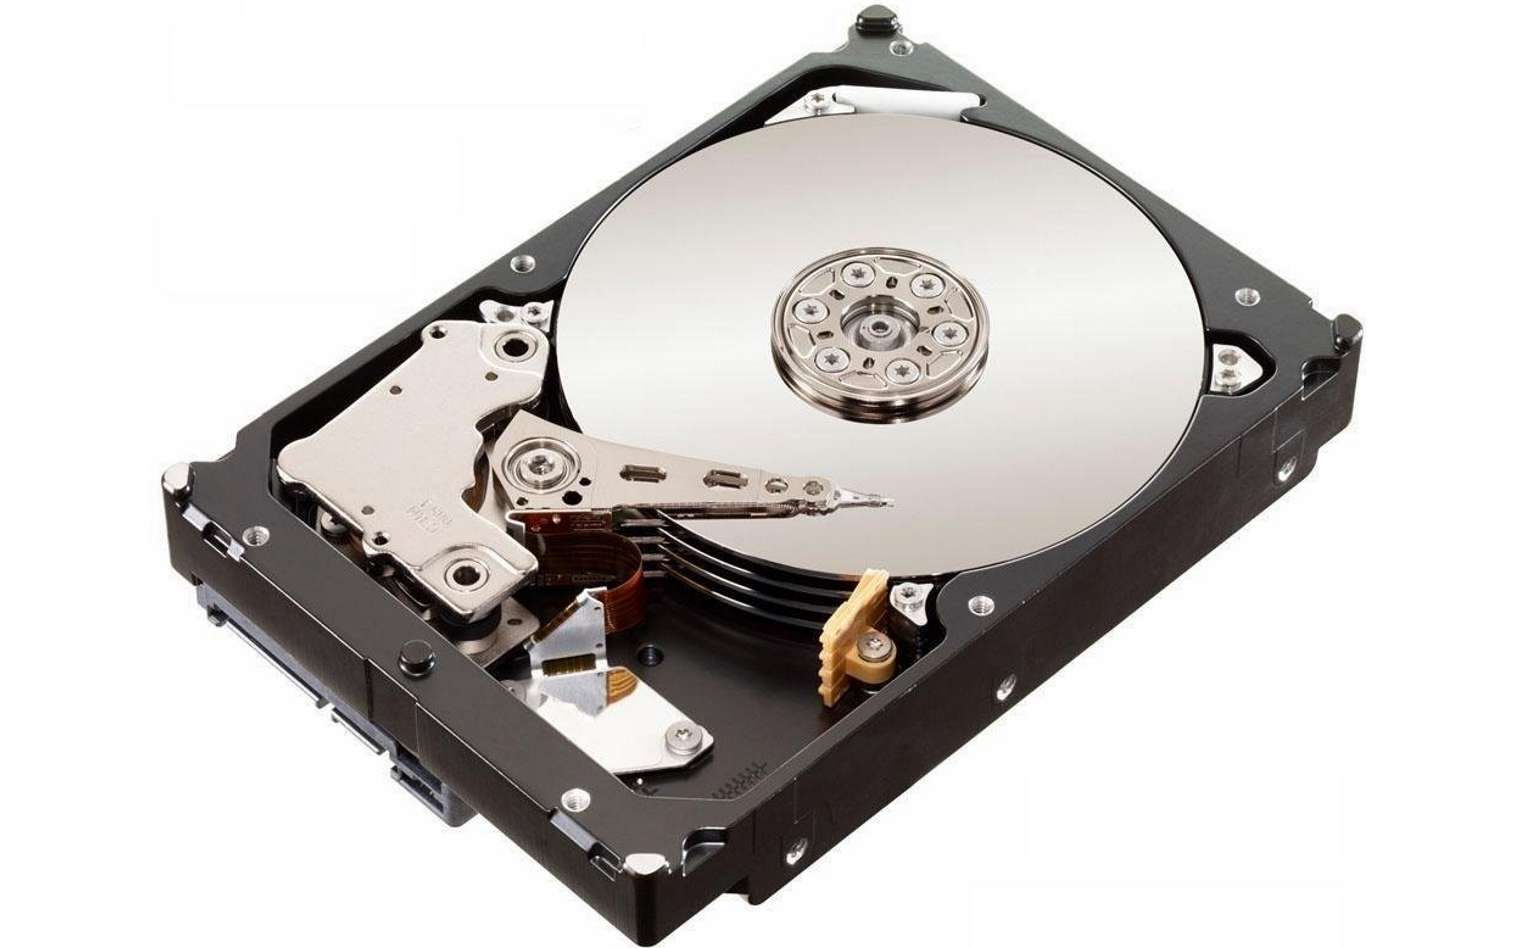
Ce petit appareil (taille 3,5"/2,5", vitesse de rotation en RPM, temps d'accès, taux de transfert, benchmark avec CrystalDiskMark) reste pertinent pour de grandes quantités de données à moindre coût que le SSD.
Bulle d'explication
La différence entre GBps et Gbps (majuscule vs minuscule) est facile à confondre, mais importante :
- 1 bit représente une donnée variant entre 0 et 1.
- 8 bits collés ensemble forment un octet (ou Byte en anglais).
- La différence entre 6 Gbps (bits) et 6 GBps (bytes) est donc un facteur 8.
Même logique pour votre vitesse Internet : à 100 Mbps (soit 12,5 MBps), un fichier de 1 Go se télécharge en environ 1000 / 12,5 = 80 secondes, soit 1 minute 20.
SSD
Un SSD (Solid State Drive) est une unité de mémoire auxiliaire qui utilise des circuits électroniques pour stocker l'information. La technologie SSD utilise des interfaces électroniques afin d'être compatible avec les technologies des disques durs traditionnels, ce qui permet aisément de les remplacer. De plus, ils utilisent les mêmes connexions SATA. Finalement, à la base ils utilisent des NAND afin de stocker l'information.
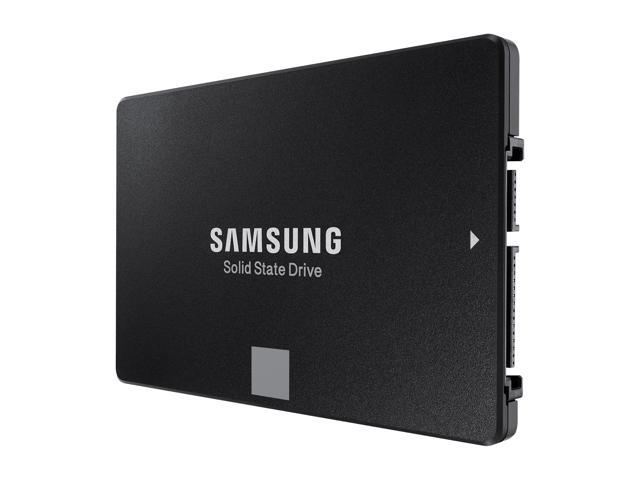
Les SSDs n'ont pas de composantes mobiles, ce qui les distingue des disques durs et disquettes.
Comparativement à ces disques:
- plus résistants aux chocs (moins de risque d'abîmer le plateau)
- plus silencieux (aucune pièce mécanique rotative)
- temps d'accès plus bas (temps avant d'obtenir la donnée)
- plus coûteux pour une grande quantité
Le temps de lecture et le temps d'écriture ne sont pas les mêmes pour tous les SSDs.
Il faut savoir qu'il y a deux façons de connecter les SSDs :
M.2 ou NVME
Des disques durs utilisant les voies PCI Ex, pour communiquer avec le CPU :
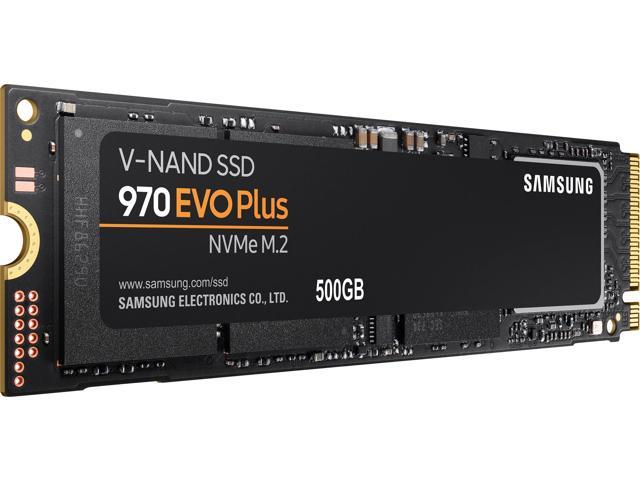
SATA
Les Samsung 870 EVO (SATA) ont une vitesse de lecture de 560 MBps et d'écriture de 530 MBps.
Entre les deux choix, les M.2 sont beaucoup plus rapides : un modèle PCIe 3.0 atteint environ 3500 MB/s, un PCIe 4.0 environ 7000 MB/s, et les modèles PCIe 5.0 récents dépassent maintenant les 10 000 MB/s.
Bien sûr que pour utiliser l'une ou l'autre des deux technologies, vous devez valider le nombre de ports SATA ou M.2 disponibles sur votre carte-mère. Lorsque vous songez à acheter un nouvel ordinateur, prenez le temps de bien choisir la carte-mère.
Clé USB
Une clé USB contient une mémoire flash et ne possède pas ou très peu d'éléments mécaniques, ce qui la rend très résistante aux chocs. Elle est idéale pour le transport des données, mais peu applicable comme solution de backups. Étant donné que vous étudiez en informatique, vous devriez vous tourner vers des solutions en ligne telles que https://github.com/ ou https://about.gitlab.com/ pour votre code, sinon tournez-vous (pas concrètement) vers des solutions en ligne pour vos documents telles que Google Drive ou Microsoft OneDrive (où grâce à votre accès étudiant, vous avez accès à 1 To).
Les clés USB peuvent être utilisées comme système d'exploitation sur un Raspberry Pi, mais généralement il y a une limite de lecture/écriture : le nombre d'écritures sur une clé USB est techniquement limité (10 000 à 100 000 selon la technologie de réalisation des cellules) (Wikipédia).
Carte SD
Les cartes SD sont utilisées pour le stockage de fichiers dans les appareils photo numériques, les caméscopes numériques, les systèmes de navigation GPS, les consoles de jeux vidéo, les téléphones mobiles dont les smartphones, ou encore les systèmes embarqués. (Wikipédia)
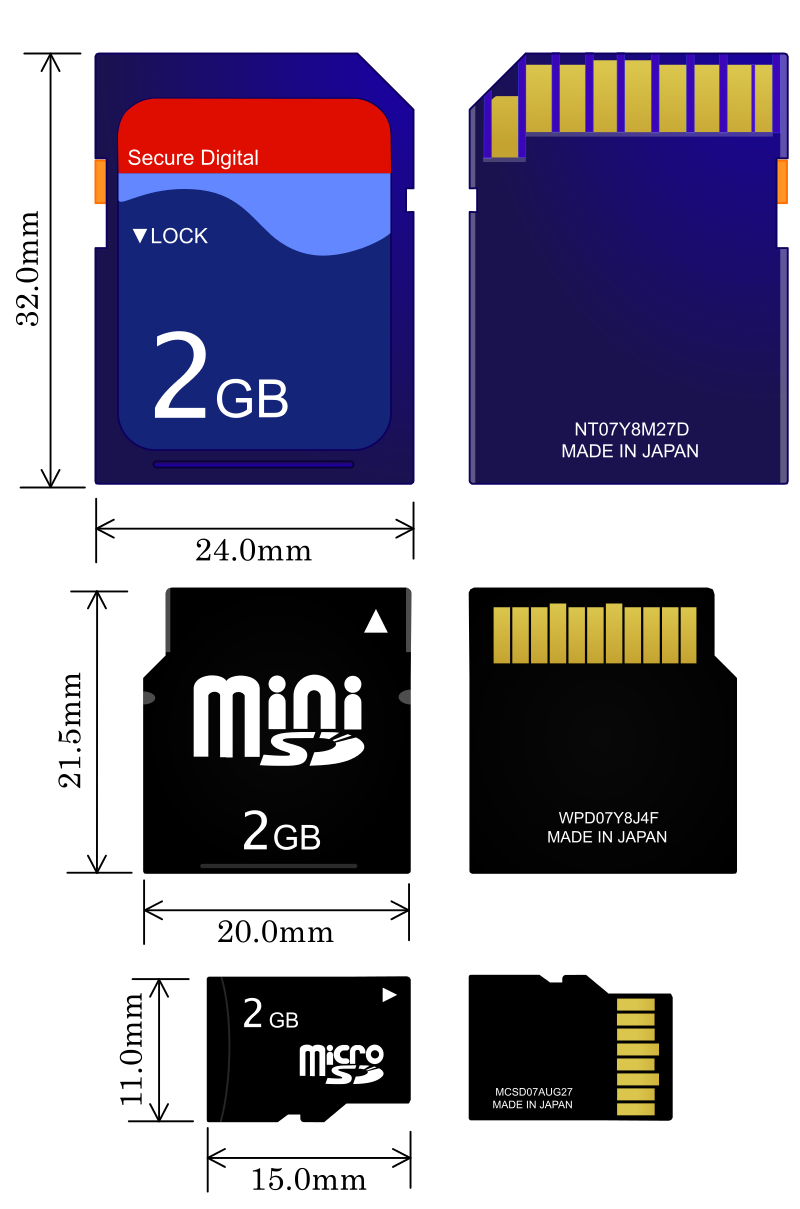
Elles sont néanmoins souvent utilisées dans l'informatique embarquée, car elles se formatent et s'insèrent facilement dans les appareils, contrairement aux clés USB, qui en ressortent plus difficilement.
Ergonomie
La bonne disposition devant son ordinateur nous permet de travailler plus longtemps, sans problème d'inconfort à long terme. Prenez le temps de bien lire le document surtout que vous risquez de vous retrouver plusieurs heures par jour assis devant votre ordinateur. Ceci est matière pour le cours.